En el creciente ecosistema de herramientas para trabajar con modelos de lenguaje (LLMs), dos nombres empiezan a sonar con fuerza: LM Studio y Ollama. Aunque ambos buscan facilitar el desarrollo y la experimentación con inteligencia artificial, sus enfoques, capacidades y públicos objetivos son bastante distintos. A continuación, los comparo desde una perspectiva práctica y centrada en el desarrollador, a través de inferencia de APIs.
❌ Ollama: más plataforma que software
Ollama se presenta como una herramienta para construir y ejecutar modelos de lenguaje, pero su propuesta está más orientada a la infraestructura que al desarrollo puro.
Funciona como una plataforma que expone una API para interactuar con LLMs, lo cual puede resultar útil si deseas integrar capacidades de IA en tus aplicaciones sin preocuparte por la complejidad de montar y mantener modelos tú mismo.
Sin embargo, su enfoque «de backend» puede no ser lo ideal para quienes buscan experimentar localmente, ajustar modelos o desarrollar sin conexión. Tampoco ofrece una interfaz gráfica orientada al usuario, y depende en gran medida de una configuración técnica más avanzada. Por eso, para quienes buscan una experiencia directa y accesible, Ollama podría quedarse corto.
✅ LM Studio: IA local para todos
Por otro lado, LM Studio destaca como una alternativa de código abierto mucho más orientada al usuario y la experimentación local.
Algunas de sus características clave incluyen:
- Instalación y descarga de modelos sin complicaciones: Su interfaz permite cargar y gestionar modelos sin necesidad de conocimientos avanzados de programación.
- Entrenamiento y despliegue de modelos personalizados: Ideal para desarrolladores que desean experimentar y ajustar sus propios LLMs.
- Modo offline: Una función crucial para entornos donde no se desea depender de servidores remotos. Esto abre la puerta a desarrollos más privados, controlados y seguros.
- SDK y CLI integrados: Para quienes buscan automatizar procesos o integrar IA localmente en sus aplicaciones, LM Studio ofrece herramientas pensadas para profesionales.
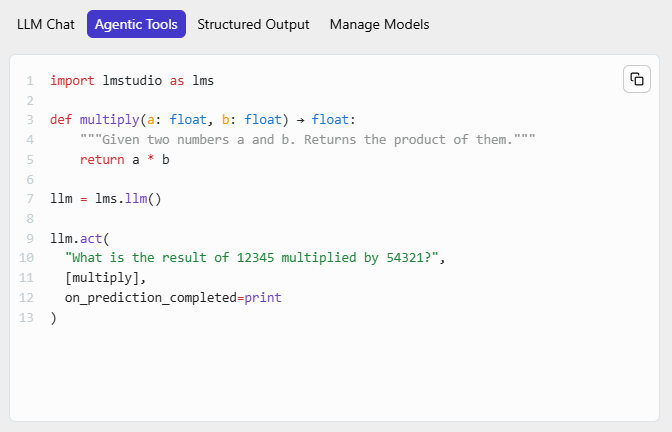
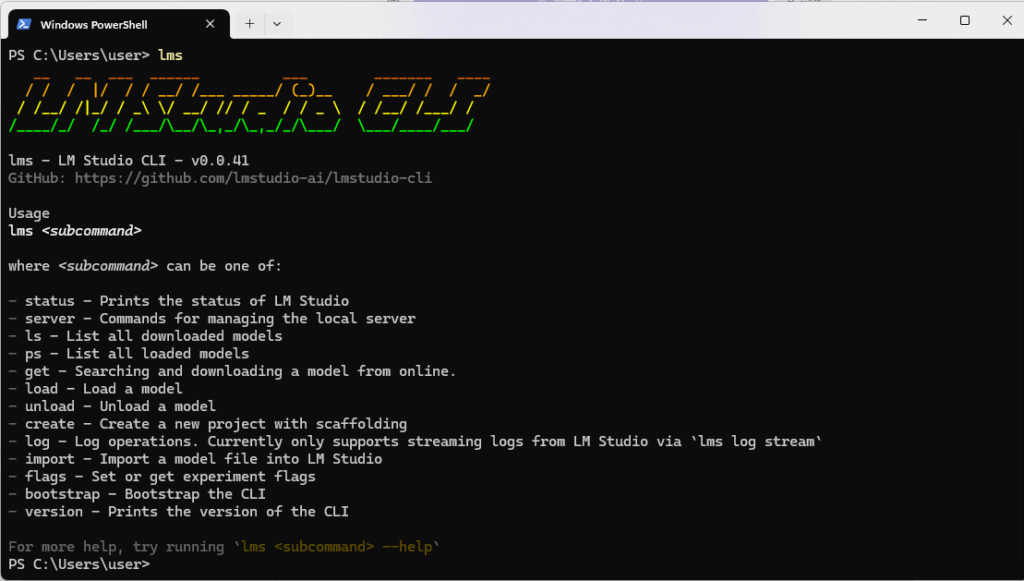
⚠️ Nota: No debe confundirse con el antiguo Machine Learning Studio de Azure, el cual está obsoleto y no guarda relación con esta herramienta.
| Factor | Ollama | LM Studio |
|---|---|---|
| Backend y API | Usa un entorno propio que ejecuta modelos como LLaMA2, Mistral, etc., con algunas optimizaciones propias, pero en un contenedor y con overhead de inicialización. | Corre localmente con backends como llama.cpp, lo que puede ser más directo, sin contenedores ni procesos adicionales. |
| Consumo de RAM | A veces más pesado por el manejo interno del modelo y servicios de red involucrados. | Puede usar menos RAM si está bien configurado (por ejemplo con quantización Q4_K_M). |
| Tiempo de arranque de inferencia | Puede tener latencia inicial mayor al llamar por HTTP y cargar modelos. | En modo API local, la respuesta puede ser inmediata si el modelo ya está en memoria. |
| Interfaz gráfica vs API | Su interfaz gráfica puede parecer más ligera que LM Studio, pero eso no se traduce en mejor rendimiento API. | Su interfaz gráfica es pesada, pero su API es rápida y directa. |
| Modelo y quantización | Puede cargar un modelo más pesado por defecto si no se especifica. | Puedes elegir quantizaciones más ligeras fácilmente. |
🧠 ¿Por qué funciona mejor LM Studio API por ejemplo en un entorno local?
- Un equipo con8-16 GB de RAM y CPU i3-i5: eso ya implica que cualquier optimización en cuanto a uso de recursos va a notarse. LM Studio usando
llama.cppcon modelos ligeros (ej.ggufen Q4_K_M o Q5_0) va más directo al grano. - API de LM Studio no tiene el overhead de procesos que introduce Ollama, que levanta contenedores u otros servicios para manejar peticiones.
- LM Studio no mantiene tanto en segundo plano y te permite tener más control sobre la carga del modelo (puedes incluso «precalentar»).
Trabajemos directamente con el código.
Para medir el desempeño de inferencia en ambas APIs, el enfoque general es tomar el tiempo total que tarda en generar la respuesta, así como contar tokens generados por segundo (tokens/s), que es una métrica común.
Aquí te muestro cómo puedes modificar tu código para LM Studio para medir:
- Tiempo total de inferencia.
- Cantidad total de tokens generados.
- Tokens por segundo.
Script con métricas que puedes comparar con una métrica en Ollama:
import lmstudio as lms
import time

llm = lms.llm()  # Get the currently loaded LLM

prompt = "In one sentence, what is a Capybara?"
print(f"Prompt: {prompt}\n")

# Iniciar el temporizador
start_time = time.time()

# Realizar inferencia
prediction = llm.respond_stream(prompt)

# Contar tokens
token_count = 0
for token in prediction:
    token_count += 1

# Terminar temporizador
end_time = time.time()

# Calcular métricas
elapsed_time = end_time - start_time
tokens_per_second = token_count / elapsed_time if elapsed_time > 0 else 0

# Mostrar resultados
print(f"\n\n--- Métricas ---")
print(f"Tiempo total de inferencia: {elapsed_time:.2f} segundos")
print(f"Tokens generados: {token_count}")
print(f"Velocidad: {tokens_per_second:.2f} tokens/segundo")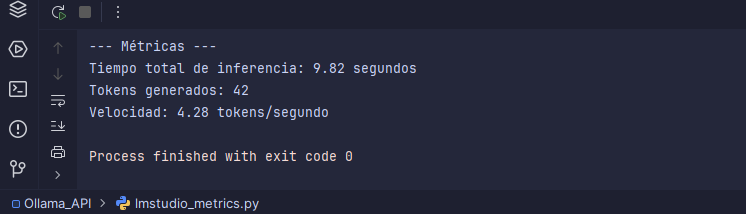
Conclusión
Si buscas una plataforma con API lista para usar y no te importa trabajar en la nube o a través de interfaces más técnicas, Ollama puede ser una opción aceptable. Pero si tu interés está en experimentar localmente, entrenar tus propios modelos y tener mayor control, LM Studio es una herramienta mucho más completa, accesible y poderosa.
¿Ya usaste alguna de estas herramientas? ¿Cuál prefieres para tus proyectos con inteligencia artificial?
 Save as PDF
Acerca del autor