Hace poco leí un post en redes sociales en el cual pretendían enumerar algunas herramientas de análisis de datos como «alternativas light» a Pandas. La etiqueta “alternativas light” suena simpática, pero técnicamente es tan útil como medir bases de datos en cucharadas. Estos proyectos no son versiones dietéticas de Pandas; son otras arquitecturas con otras prioridades. Lo que funciona mejor es describirlos según el modelo de ejecución, el tipo de motor, o el propósito dentro del ecosistema de análisis.
La versión clara y sin humo sería esta: Pandas es magnífico, pero fue diseñado para trabajar en memoria, en una sola máquina y con ciertos límites prácticos. Surgen entonces estos “hermanos divergentes” que optimizan distintas piezas del rompecabezas.

Problemas principales de Pandas con Big Data
- Consumo de RAM: Pandas carga todo el conjunto de datos en la memoria RAM, lo que es inviable para archivos grandes, y las operaciones a menudo crean copias, agotando la memoria.
- Escalabilidad limitada: No está diseñado para datasets que exceden la RAM disponible, generando errores de memoria (OOM) o rendimiento extremadamente lento.
- Inferencia de tipos: Para
read_csv, Pandas lee todo el archivo para inferir los tipos de datos (dtype), lo que puede ser lento y consumir mucha memoria, aunque se puede optimizar condtypeylow_memory=False. - Operaciones ineficientes: Algunas operaciones, como usar espacios en nombres de columna o trabajar con tipos de datos mixtos (ej.,
objecten lugar de numéricos), ralentizan el proceso.
Soluciones y alternativas
Motores columnar y vectorizados
Aquí encajan Polars y DuckDB. Operan sobre memoria columnar y aplican optimización vectorizada. La palabra clave es “columnar execution engine”. Más riguroso que “light”, y explica por qué vuelan.
Recomendamos la lectura de Polars vs pandas: What’s the Difference?
Herramientas de análisis out-of-core
Significa que no dependen de cargar todo en RAM. DuckDB entra aquí. También Dask, según cómo lo uses. Describe la capacidad de procesar datasets más grandes que la memoria.
Los DataFrames de Dask usan pandas internamente, por lo que tu código actual probablemente funcione. Se autoproclama como más rápido y sencillo que Spark, del que hablaremos mas adelante.
Frameworks de cómputo distribuido o paralelo
Dask es el ejemplo perfecto. Si quieres posicionarlo, este es su hogar conceptual. Nada de “light”: es más bien un Pandas con músculo distribuido.
Infraestructura de memoria y formato interoperable
PyArrow es esto. No compite con Pandas; lo habilita. Aquí el término correcto es “formato de memoria columnar” y “capa de interoperabilidad”.
Motores analíticos embebidos
DuckDB otra vez. Similar en espíritu a “SQLite para análisis”. Es una categoría emergente que se entiende bien.
DataFrames de siguiente generación
Polars y, en parte, Pandas 2.x con Arrow. Sirve para presentar la idea general sin comprometer rigor, y está organizado para operaciones analíticas eficientes en hardware moderno como CPU y GPU.
Spark, el peso pesado del análisis de datos, y más …
Spark es la jugada que hace un programador cuando pasa de “quiero manejar bien mis datos” a “quiero domar un rebaño de mamuts sin despeinarme”.

La apuesta por Spark tiene lógica y comprobada. Es un ecosistema completo, no solo una librería o motor columnar. Está pensado para distribuir trabajo por naturaleza, no como un parche posterior. La idea de “describir la transformación” y dejar que el cluster decida cómo ejecutarla es tremendamente elegante. Ese modelo declarativo–con su optimizador Catalyst y el formato columnar de Tungsten–lo convierte en un titán dentro del procesamiento masivo.
Tiene un detalle que lo hace distinto del resto del cúmulo de alternativas que se encuentran en el marketplace de plataformas: Spark no pretende ser ligero, pretende ser escalable sin pedir permiso. Cuando un dataset de 500 GB ya no cabe en los modos Arrow/Polars/DuckDB + “máquina grande”, Spark sigue adelante como si nada. Es la diferencia entre un coche deportivo rápido y un tren eléctrico capaz de arrastrar un kilómetro de carga.
En un punto intermedio del ecosistema, Spark tiene esa mezcla rara de pragmatismo y poder que encaja en muchísimas arquitecturas empresariales: ETL pesados, machine learning distribuido, continuos de streaming, y la integración con Delta Lake y los lakehouses modernos. Cuando los sistemas empiezan a hablar de petabytes o pipelines diarios con latencia aceptable, Spark es el idioma natural.
API de pandas en Spark
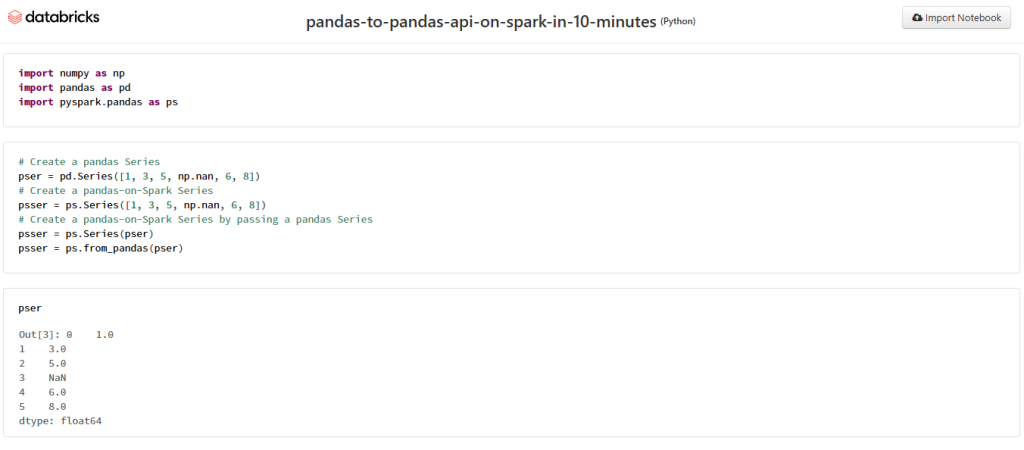
La API de pandas en Spark es uno de esos inventos que parecen un truco de magia, pero en realidad es ingeniería pura: te deja escribir código casi igual al de Pandas, pero se ejecuta sobre el motor distribuido de Spark. Así se rompe el muro entre “código cómodo” y “escala industrial”.
La historia detrás es curiosa. Antes existía Koalas, un proyecto externo que imitaba Pandas usando Spark por debajo. Tuvo tanto éxito que pasó a formar parte oficial de Spark desde la versión 3.2. Hoy vive como pyspark.pandas (y en nuevas versiones como pandas API on Spark).
La idea es esta:
«si ya sabes Pandas, no necesitas reaprender Spark DataFrames de inmediato. Puedes escribir cosas como:»
import pyspark.pandas as ps

df = ps.read_csv("datos.csv")
df["col_nueva"] = df["valor"] * 10
df.groupby("categoria").mean()
pero Spark decide cómo particionar, distribuir, planificar, ejecutar y optimizar todo eso en un cluster. Cada operación se traduce en un plan distribuido que Spark entiende.
Hay matices importantes que dan sabor al invento:
El API no es Pandas al 100%, porque Spark es distribuido, y el mundo distribuido impone restricciones: no puedes asumir que todo está en RAM local, ni que puedes iterar fila por fila, ni que una operación trivial en Pandas tenga la misma semántica en cluster. Pero la compatibilidad es lo bastante cercana como para convertir migraciones en algo mucho menos doloroso.
El API de Spark DataFrame clásico sigue siendo más explícito y más poderoso cuando necesitas control fino o rendimiento máximo. La API de pandas en Spark es más para reducir fricción y permitir que equipos enteros adopten Spark sin una curva de aprendizaje empinada.
Cuando se combina con Delta Lake, Parquet y el optimizador Catalyst, este API te permite escribir “código de cuaderno”, pero obtener “rendimiento de mega-pipeline”.
Spark, en comparación con Pandas y demás alternativas, se planta y suelta algo así como:
“¿Quieres seguir usando Pandas? Perfecto. Te doy una capa casi idéntica… y por debajo monto un cluster entero que ejecuta tu código como si fueran legiones romanas procesando Parquet.”
 Save as PDF
Acerca del autor