Businessman using smartphone typing to send message to colleague , Communication by chat and social network technology concept.
En el mundo de las aplicaciones web modernas, los chatbots inteligentes están ganando cada vez más terreno. Recientemente desarrollé una aplicación de chat en Django que utiliza Ollama para generar respuestas usando un modelo LLM (llama3.2:1b), enfocada en la simplicidad, la respuesta concisa y la persistencia del contexto.
Este desarrollo tiene fines educativos, y en este artículo comparto los fundamentos de su implementación, destacando las ventajas que Django nos ofrece en este tipo de soluciones.
¿Por qué Django?
Django es uno de los frameworks más robustos para desarrollo web en Python. Su sistema de vistas, gestión de sesiones, seguridad incorporada y el potente panel de administración hacen que sea ideal para aplicaciones de este tipo. En este caso, el uso de sesiones nos permitió almacenar el historial de conversación sin necesidad de una base de datos adicional o complejas estructuras de almacenamiento.
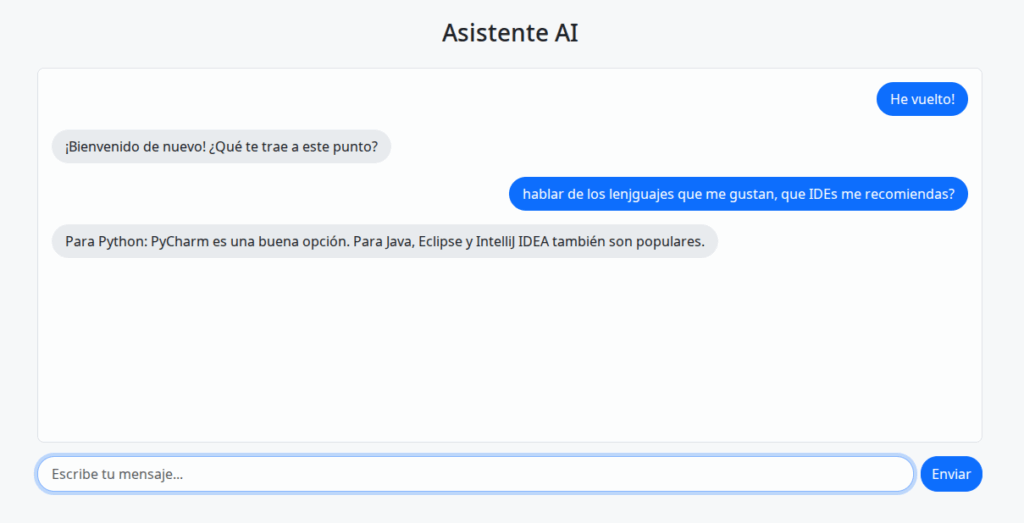
Cómo funciona el chat
La vista chat_view recibe los mensajes del usuario mediante POST y los envía a una función generate_response() contenida en ollama_api.py. Esta función utiliza ollama.chat en modo streaming, lo cual permite entregar la respuesta en tiempo real, fragmento por fragmento, mejorando la experiencia del usuario.
Un aspecto clave es que la conversación se mantiene en la sesión del navegador:
chat_history = list(request.session.get('chat_history', []))
El historial está limitado a los últimos 12 mensajes del usuario y del asistente, más un SYSTEM_PROMPT personalizado que orienta al modelo a responder de manera corta, clara y sin adornos:
SYSTEM_PROMPT = {
    'role': 'system',
    'content': (
        'Responde exclusivamente en una oración corta y clara. '
        'Evita adornos o explicaciones largas. '
        'Recuerda las preguntas anteriores y responde de forma coherente con el contexto.'
    )
}
Debugging visible: una ayuda poderosa
Durante el desarrollo, se añadió salida en consola para depurar el contenido del historial antes y después de la generación de respuesta:
print(json.dumps(chat_history, indent=2, ensure_ascii=False))
Consideraciones de seguridad
Este proyecto tiene fines educativos, por lo que la seguridad y privacidad deben ser mejoradas para un uso en producción, por ejemplo, cifrando las sesiones o almacenando los datos en una base de datos controlada.
Como el historial se almacena en la sesión del usuario, es importante recordar que no se deben enviar datos sensibles.
Visualización del historial desde el Admin
Django permite fácilmente extender el módulo de administración. Basta con agregar el modelo Session al dashboard para poder ver directamente el contenido de las sesiones activas:
from django.contrib.sessions.models import Session
from django.contrib import admin

admin.site.register(Session)
Esto es útil para revisar cómo el historial evoluciona y qué tipo de entradas están almacenadas.

Código base de la función generadora
La función que realiza la consulta a Ollama se encuentra en ollama_api.py y es extremadamente simple:
import ollama

def generate_response(messages):
    stream = ollama.chat(
        model='llama3.2:1b',
        messages=messages,
        stream=True,
    )
    for chunk in stream:
        yield chunk
Gracias al streaming, la interfaz puede presentar la respuesta conforme se va generando, lo que reduce la sensación de espera.
El código de la vista en chat/views.py:
import json
from django.shortcuts import render
from django.http import StreamingHttpResponse
from django.views.decorators.csrf import csrf_exempt
from .ollama_api import generate_response

SYSTEM_PROMPT = {
    'role': 'system',
    'content': (
        'Responde exclusivamente en una oración corta y clara. '
        'Evita adornos o explicaciones largas. '
        'Recuerda las preguntas anteriores y responde de forma coherente con el contexto.'
    )
}

MAX_HISTORY = 12

@csrf_exempt
def chat_view(request):
    print("\n--- INICIO DE CHAT_VIEW ---")
    print(f"Método de la solicitud: {request.method}")
    print(f"Session Key inicial: {request.session.session_key}")
    print(f"Cookies recibidas: {request.COOKIES}")

    if request.method == "POST":
        user_input = request.POST.get("user_input", "").strip()
        if not user_input:
            return StreamingHttpResponse("Entrada vacía.", content_type='text/plain')

        # Obtener historial desde sesión.
        chat_history = list(request.session.get('chat_history', []))

        # --- DEBUG: Después de cargar de la sesión ---
        print(f"DEBUG: chat_history *después de cargar de la sesión*: {json.dumps(chat_history, indent=2, ensure_ascii=False)}")

        # Asegúrate de que el SYSTEM_PROMPT esté al inicio si el historial está vacío o no lo tiene
        if not chat_history or (chat_history and chat_history[0]['role'] != 'system'):
            chat_history.insert(0, SYSTEM_PROMPT)

        # Agregar mensaje del usuario
        chat_history.append({'role': 'user', 'content': user_input})

        # Limitar historial (asegurando el SYSTEM_PROMPT se mantiene)
        if len(chat_history) > MAX_HISTORY + 1:
            chat_history = [chat_history[0]] + chat_history[1:][-(MAX_HISTORY):]

        print("\n=== Historial enviado a Ollama ===")
        print(json.dumps(chat_history, indent=2, ensure_ascii=False))
        print("=== Fin del historial ===\n")

        response_generator = generate_response(chat_history)

        def stream_and_save_response(current_chat_history, current_request):
            full_assistant_response = ''
            for chunk in response_generator:
                content = chunk['message']['content']
                full_assistant_response += content
                yield content

            current_chat_history.append({'role': 'assistant', 'content': full_assistant_response})

            # Limitar historial nuevamente antes de guardar (mantiene SYSTEM_PROMPT)
            if len(current_chat_history) > MAX_HISTORY + 1:
                current_chat_history = [current_chat_history[0]] + current_chat_history[1:][-(MAX_HISTORY):]

            current_request.session['chat_history'] = current_chat_history
            current_request.session.modified = True
            current_request.session.save() # <-- ¡NUEVA LÍNEA CLAVE!

            print(f"\n--- DEBUG: Sesión guardada con historial final. Modified: {current_request.session.modified} ---")
            print(f"DEBUG: Historial guardado en request.session['chat_history'] es: {json.dumps(current_request.session.get('chat_history'), indent=2, ensure_ascii=False)}")
            print("--- FIN stream_and_save_response ---")

        return StreamingHttpResponse(stream_and_save_response(chat_history, request), content_type='text/plain')

    # GET: renderizar plantilla de chat
    return render(request, "chat.html")
Esta pequeña pero poderosa aplicación demuestra cómo Django puede integrarse perfectamente con LLMs y herramientas como Ollama para crear experiencias conversacionales fluidas y persistentes. Al usar sesiones para almacenar el historial y limitarlo cuidadosamente, se logra un balance entre rendimiento y contexto útil.
Si estás explorando cómo crear un chatbot educativo, esta arquitectura puede servir como un gran punto de partida.
Repositorio en Github >> https://github.com/DaveSV/Django-Sessions-Ollama-Chat-App-.git
 Save as PDF
About the Author